---
title: "Kubernetes Skalierung in der Google Cloud"
description: "Erfahre anhand eines API-Praxisbeispiels, wie der Horizontal Pod Autoscaler eingerichtet werden kann."
canonical_url: "https://www.blueshoe.de/blog/kubernetes-skalierung-gke/"
---
In diesem Artikel geht es um die Möglichkeit, Kubernetes Workloads in der Google Cloud einfach und nachhaltig zu skalieren.
Skalierung der API - zu viel und zu wenig
Kubernetes erlaubt es bereits auf einfache Art und Weise, Workloads zu skalieren. Für diesen Artikel wird eine zustandslose (stateless) Application angenommen - eine simple REST API.
Diese ist in Form eines Deployments mit 4 Replicas (je 125 mCPU und 250 Mi Memory) im GKE Autopilot Cluster vorhanden.
**Problemstellung:** Nachts laufen diese 4 Replicas nahezu ohne Last. Am Tag reichen diese teilweise nicht aus.
**Lösung:** Automatische Skalierung der Services basierend auf deren Auslastung.
*Im schlechtesten Falle werden die Applikationen während hoher Last noch OOM Killed - weil sie zu viel Speicher verbrauchen.*
Wie viel CPU oder Arbeitsspeicher brauchen meine Pods?
Bevor die Skalierung konfiguriert wird, ist es wichtig herauszufinden, - was eigentlich
typische Metriken für das Verhalten der zu skalierenden Applikation sind . Verbraucht diese viel CPU oder viel Arbeitsspeicher? Gibt es eine andere Metrik, welche mir Aufschluss über die Auslastung gibt (z.B. *Request Queue*-Länge)?
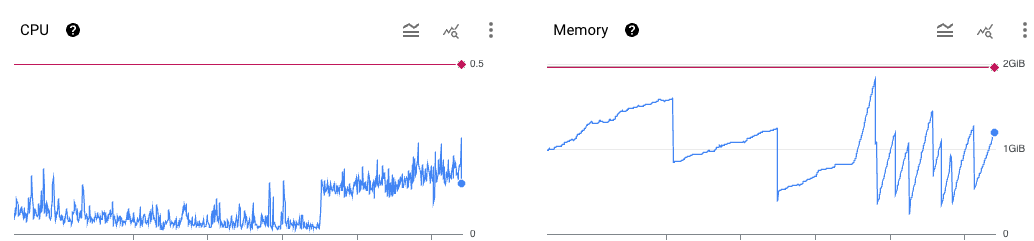
Ein einfacher Blick in die Google Cloud Dashboards unserer REST API zeigt, dass der Arbeitsspeicher schwankt und die CPU ab einem bestimmten Zeitpunkt eine recht konstante Auslastung hat. Die blaue Linie zeigt die tatsächliche Auslastung, die rote Linie die Limits.
Der Arbeitsspeicher scheint hier deutlich volatiler und näher an seinen Limits - für die Skalierung unserer Applikation in Kubernetes wird der Memory als Grundlage genutzt.
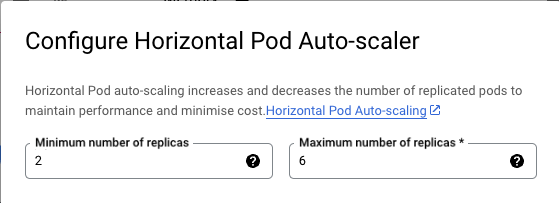
Nun ist zwar klar, welche Metrik hergenommen wird, allerdings noch nicht, was die notwendigen Parameter sind. Die Memory Auslastung fällt selten unter 250 MB, was bedeutet, dass mindestens 2 Pods ständig verfügbar sein sollten.
Wir laufen selten, aber zuverlässig an die Kapazitätsgrenze der aktuell 4 verfügbaren Replicas. Also nehmen wir mit etwas Puffer maximal 6 Replicas als höchste Auslastung an.
*Anmerkung: Stark fluktuierende Auslastung des Arbeitsspeichers deutet auf Probleme in der Applikation hin. In diesem Falle ein Memory-Leak einer Abhängigkeit, welche nicht verändert werden kann.*
Skalierung in Kubernetes: der Horizontal Pod Autoscaler
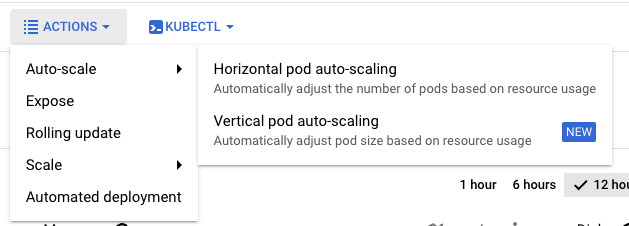
Die Google Cloud erlaubt sowohl vertikale als auch horizontale Skalierung von Workloads. Vertikale Skalierung bedeutet, dass die verfügbaren Ressourcen (CPU, Memory) von Pods skaliert werden. Horizontale Skalierung erzeugt und entfernt ganze Pods desselben Deployments.
Die grundlegenden Parameter sind schnell erstellt - das Minimum und Maximum der Skalierung der API ist mit den folgenden 2 Feldern erledigt:
Wir können auch Deine Apps dynamisch an den Bedarf anpassen.
Doch was ist nun die Baseline für die Skalierung selbst? Es wird einfach - für unser Beispiel - eine gewünschte “Idealauslastung” pro Pod festgelegt. Das Limit eines jeden Pods liegt bei 250 MB. Mit einer Auslastung von 80% oder 200 MB kommen wir (mit etwas Puffer) an die Belastungsgrenze des Services und brauchen eine neue Instanz.
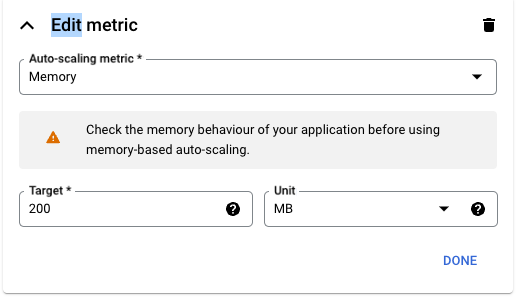
Da das definierte Minimum 2 Pods sind - wird, sobald die Memory Auslastung im Schnitt 400 MB überschreitet, ein weiterer Pod hinzu skaliert. Wird diese dann wieder unterschritten, so entfernt der Horizontal Pod Autoscaler (HPA) diesen auch wieder.
Für alle Kubernetes Experten - natürlich lässt sich der HPA auch über Kubernetes Ressourcen definieren und somit als Konfiguration im Cluster hinterlegen - das typische DevOps Vorgehen.
```yaml
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: store-autoscale
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: store-autoscale
minReplicas: 2
maxReplicas: 6
metrics:
- resource:
name: memory
target:
averageValue: 200
type: AverageValue
```
Fazit
Mit ein paar Klicks - oder auch einer einfachen Kubernetes Ressourcen - lassen sich Kosten sparen und die Lastspitzen der REST API einfach abfangen.
## Sitemap
See the full [sitemap](/sitemap.md) for all pages.