---
title: "Wie geht Kubernetes Development?"
description: "Development mit Kubernetes ist die Zukunft. Aber was bedeutet es eigentlich, wenn man sich für Cloud Native entscheidet? Wir erklären es dir!"
canonical_url: "https://www.blueshoe.de/blog/kubernetes-development/"
---
"Kubernetes Development" a.k.a. “Entwicklung containerisierter Micro-Services in einem lokalen Kubernetes Cluster” bedeutet, dass Anwendungen für eine Kubernetes-Architektur konzipiert und entwickelt werden, also ein Entwickler auch lokal mit einer Kubernetes-Architektur arbeitet. In diesem Blogpost zeigen wir euch, wie wir bei Blueshoe diese Aufgabe bewerkstelligen.
“Cloud Native Kubernetes Development” a.k.a. wie kann ich möglichst **viele techy Buzzwords** in einen kurzen Blogtitel verpacken? Eigentlich möchte man auch noch “k8s” unterbringen, was als Kurzform für “Kubernetes” verwendet wird, aber wir wollen es auch nicht übertreiben. Um diesen Blogpost zu verstehen, wird ein gewisses **Grundverständnis von Kubernetes** vorausgesetzt. Falls das nicht gegeben ist, können wir diesen [Comic](https://cloud.google.com/kubernetes-engine/kubernetes-comic) von Google empfehlen.
Nehmen wir an, du entwickelst ein neues Projekt, hast ein paar unabhängige Services darin identifiziert und bist zu dem Entschluss gekommen, dass es durchaus Sinn macht, diese in **separate Container** zu deployen und von **Kubernetes orchestrieren** zu lassen. Da es ein größeres Projekt ist, arbeiten mehrere Programmierer daran, die jeder für sich oder in kleinen Teams nur an je einem der Services arbeiten.
**STATUS-QUO**
Das gerade beschriebene **Projektbeispiel** hat sich mittlerweile zu einem durchaus üblichen Szenario entwickelt. Wie können wir nun gewährleisten, dass unsere Programmierer auch auf ihrem lokalen Laptop möglichst äquivalent zur Kubernetes-Architektur entwickeln können? Ein üblicher Weg, um Docker-Container lokal auszuführen ist *docker-compose*. Dieses ist vor allem in der Handhabung sehr einfach, hat aber den großen Nachteil, dass ein docker-compose-Setup nicht die letztendliche Production-Umgebung, also das Kubernetes-Setup abbildet. Im schlimmsten Fall hast du also etwas programmiert, das lokal in deinem docker-compose-Setup funktioniert, im Production-System dann aber nicht, da das Image anders ausgeführt wird.
Als Alternative wurden Technologien entwickelt, um Kubernetes Cluster auf dem lokalen Rechner zu simulieren. *Minikube* ist eine recht verbreitete Lösung, in letzter Zeit sind aber auch mehr und mehr Alternativen auf dem Vormarsch. Hier sind z.B. *microk8s* von Canonical zu nennen, oder *k3s* und *k3d* von Rancher, welche ressourcenschonender sind. K3d benutzt k3s, um mehrere *Worker Nodes* im lokalen Kubernetes-Cluster zu simulieren. Üblicherweise wird dann *kubectl* benutzt, um mit dem Cluster zu interagieren.
Als Entwickler musst du nun lediglich ein Docker-Image deines Services builden und deinen Kollegen zur Verfügung stellen. Diese können das Image in ihrem lokalen Cluster deployen und haben daraufhin den aktuellsten Stand deines Services lokal zur Verfügung.
**ZWEI SPANNENDE HERAUSFORDERUNGEN SIND ZU DIESEM ZEITPUNKT ALLERDINGS NOCH OFFEN:**
1. Wie kann ich an meinem Service arbeiten und stets den aktuellen Stand in meinem Cluster zur Verfügung haben, ohne ein neues Image builden und deployen zu müssen?
2. Wie kann ich lokal den Debugger verwenden?
**KUBERNETES (CLOUD NATIVE) DEVELOPMENT BEI BLUESHOE**
In den nächsten Abschnitten wollen wir uns anschauen, wie wir bei Blueshoe diese Herausforderungen meistern. Wir setzen dabei auf **k3d** als **lokalen Kubernetes-Cluster** sowie *PyCharm* als unsere **Entwicklungsumgebung**. Weiterhin nutzen wir **Helm** für das **Management des Clusters** sowie **Telepresence** um **live Code-Reloading** zu bewerkstelligen. Die folgenden Installationsbeispiele wurden alle auf einem aktuellen Ubuntu-System durchgeführt.
**K3D/K3S - “LIGHTWEIGHT KUBERNETES IN DOCKER”**
k3d lässt sich sehr einfach installieren, Rancher stellt ein Installations-Script zur Verfügung:
```docker
wget -q -O - https://raw.githubusercontent.com/rancher/k3d/master/install.sh | bash
```
Die Installation von k3s ist ebenso simpel:
```docker
curl -sfL https://get.k3s.io | sh -
```
Ein neuer Cluster lässt sich mit folgendem Befehl anlegen:
```docker
k3d create --api-port 6550 --publish 8080:80 --workers 2 --name buzzword-counter --enable-registry
```
Wir haben hier einen Cluster namens **buzzword-counter** erzeugt und u.a. den lokalen Port 8080 auf den Cluster-internen Port 80 gemappt, sodass wir unseren Cluster im Webbrowser unter dem Port 8080 erreichen können. Zusätzlich ermöglichen wir mit der Flag *--enable-registry*, dass lokale Docker-Images im Cluster deployed werden können. Die *lokale Registry* ist ein gewöhnlicher Docker-Container, der sich z.B. nach einem Neustart des Rechners mit *"docker restart <>"* wieder starten lässt. Dafür benötigen wir zusätzlich einen entsprechenden Eintrag in unserer */etc/hosts* Datei:
```docker
[...]
127.0.0.1 registry.local
[...]
```
Damit wir mittels kubectl mit unserem Cluster interagieren können, können wir entweder die **KUBECONFIG-Umgebungsvariable** exportieren oder den Inhalt der entsprechenden Datei in *~/.kube/config* integrieren:
```docker
export KUBECONFIG="$(k3d get-kubeconfig --name='buzzword-counter')"
```
**HELM - “KUBERNETES PACKAGE MANAGER”**
Wir benutzen oftmals Helm, um unsere Kubernetes Cluster zu managen. Helm beschreibt sich selbst als Package Manager für Kubernetes und ermöglicht auch die **Abbildung komplexer Kubernetes Anwendungen in Templates.** Das Buzzword lautet hier **“Infrastructure as Code”.** Durch die Templates kann unsere Anwendung jederzeit ohne größeren Aufwand in einen neuen Kubernetes Cluster deployed werden. Um Helm zu installieren, kann man einfach eine Binary-Datei herunterladen: [Zum Download](https://get.helm.sh/helm-v2.16.5-linux-amd64.tar.gz).
**BEISPIEL-DEPLOYMENT BUZZWORD-COUNTER**
Um ein praktisches Beispiel zeigen zu können, haben wir ein simples Deployment für diesen Blog-Post erstellt und auf Github bereitgestellt:
[BUZZWORD COUNTER](https://github.com/Blueshoe/buzzword-counter)
[BUZZWORD CHARTS](https://github.com/Blueshoe/buzzword-charts)
Dieses Deployment enthält eine einfache Django-Anwendung, eine *Celery Distributed Task Queue* mit *rabbitmq* als Message Broker, **um asynchrone Tasks abzuarbeiten**, sowie eine **PostgreSQL Datenbank**. Mittels unserer Anwendung können wir Buzzwords zählen und auch neue Buzzwords hinzufügen. Letzteres ist als Celery-Task implementiert, was in diesem Beispielszenario zwar recht unnötig ist, aber die Funktionsweise unserer Celery Distributed Task Queue bestens demonstriert.
Der erste Schritt des Deployments ist das Bereitstellen der Anwendung als Docker-Image. Dazu müssen wir zunächst das **Docker-Image** builden (aus dem Verzeichnis der Django Anwendung) und in unsere lokale Registry pushen:
```docker
docker build -t registry.local:5000/buzzword-counter:0.1.0 .
docker push registry.local:5000/buzzword-counter:0.1.0
```
Mit folgenden Befehlen (aus dem Verzeichnis der Helm Charts) wird die Anwendung mit der PostgreSQL- und der rabbitmq-Dependency im Kubernetes-Cluster installiert und konfiguriert:
```docker
helm repo add bitnami https://charts.bitnami.com/bitnami
helm dep build buzzword-counter
helm install buzzword-counter buzzword-counter/
```
Mittels kubectl können wir uns z. B. anschauen, ob die Pods verfügbar sind, oder auch den Log-Output anzeigen lassen und verifizieren, dass einerseits der Runserver auf dem Web-Pod sowie der Celery-Worker auf dem Worker-Pod gestartet wurde:
```bash
kubectl get deployments
kubectl get pods
kubectl logs -f buzzword-counter-web-XXXXX-XXXXXXXX
kubectl logs -f buzzword-counter-worker-XXXXX-XXXXXXXX
```
Nun haben wir also einen lokalen Kubernetes-Cluster, in dem unsere Anwendung installiert und konfiguriert ist. Damit wir unsere Seite lokal erreichen können, müssen wir noch folgende drei Befehle ausführen, die uns der Output von helm install ausgegeben hat:
```bash
export POD_NAME=$(kubectl get pods --namespace default -l "app.kubernetes.io/name=buzzword-counter,app.kubernetes.io/instance=buzzword-counter" -o jsonpath="{.items[0].metadata.name}")
echo "Visit http://127.0.0.1:8080 to use your application"
kubectl --namespace default port-forward $POD_NAME 8080:80
```
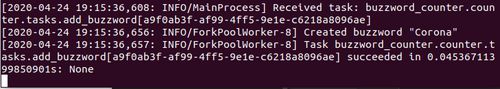
Daraufhin können wir unseren Service auf der angegebenen URL erreichen. Starten wir einen Task, können wir uns dessen Output mittels kubectl im Log des Worker-Pods ansehen:
```bash
kubectl logs -f buzzword-counter-worker-XXXXX-XXXXXXXX
```
**TELEPRESENCE - “FAST, LOCAL DEVELOPMENT FOR KUBERNETES”**
Um **live Code-Reloading** zu erreichen, d.h. um Code-Änderungen, die wir in PyCharm tätigen, sofort im Cluster verfügbar zu haben, verwenden wir Telepresence. Telepresence ist ein sogenanntes **Sandbox-Projekt der CNCF**, der **Cloud Native Computing Foundation**. Ohne live Code-Reloading müssten wir nach jeder Änderung ein neues Docker-Image builden und im Cluster deployen, was umständlich und auf Dauer zeitintensiv ist.
Mittels *Telepresence* kannst du nun ein Docker-Image, das du lokal gebaut hast, in einem Cluster ausführen, indem ein **Deployment “geswapt”** wird. Technisch ist das durchaus spektakulär, für diesen Blog-Post genügt es jedoch, dass wir mit einem Command unser **Buzzword-Counter-Web-Deployment** unseres Kubernetes-Clusters austauschen können und stattdessen das angegebene Docker-Image ausgeführt wird. Zuvor müssen wir noch das Docker-Image bauen. Für beide Befehle müssen wir im **Verzeichnis des Source Codes unserer Django-Anwendung** sein:
```docker
docker build -t buzzword-counter:local .
telepresence --swap-deployment buzzword-counter-web --expose 8080 --docker-run --rm -it -v $(pwd):/code buzzword-counter:local python manage.py runserver 0.0.0.0:8080
```
Mit der Flag *“-v $(pwd):/code”* haben wir zusätzlich das aktuelle Verzeichnis in den **Docker-Container gemounted**, sodass die Code-Änderungen in *PyCharm* auch im Kubernetes-Cluster verfügbar sind. Da wir den Django-Runserver benutzen, funktioniert das live Reloading allerdings nur, wenn *DEBUG=True* gesetzt ist. Das können wir entweder **über die Helm-Charts deployen oder einfach in unserem geswappten Deployment exportieren.** Danach führen wir das *run-Script* aus:
```docker
export DJANGO_DEBUG=True
/usr/src/run_app.sh
```
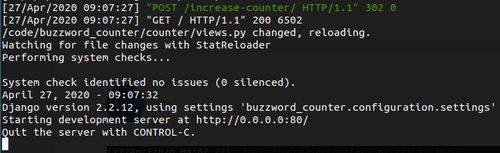
Wenn wir den Container swappen, müssen wir wieder die drei Befehle von oben für den *port-forward* des Pods ausführen. Daraufhin können wir Code in *PyCharm* ändern und einerseits im Log oder durch das Aufrufen der Seite im Browser verifizieren, dass der Runserver neu gestartet wurde:
Wer genauer hinschaut, wird feststellen, dass **Telepresence** nicht auf einen lokalen Cluster beschränkt ist. Es lassen sich auch **Deployments von remote Clustern** swappen, sofern der Zugriff mittels *kubectl* möglich ist. Das kann z.B. zum Debuggen und Nachvollziehen von Bugs auf Test-Systemen sehr nützlich sein. Allerdings ist hier Vorsicht geboten, denn jeder **Traffic des Deployments** wird nach dem Swappen auf den lokalen Laptop geleitet. Das heißt dieses Vorgehen bietet sich maximal für **Test-Systeme** an und sollte bei den **allermeisten Produktiv-Systemen** tunlichst gemieden werden.
**PYTHON REMOTE DEBUG IN PYCHARM**
Mittlerweile können wir also unsere Anwendung im lokalen Kubernetes-Cluster mit live Code-Reloading deployen. Wir haben unsere gebuzzwordete Mission erfüllt, die **Production-Kubernetes-Umgebung ist lokal nachgebildet** und wir können *cloud native* an unserem Service entwickeln. Das i-Tüpfelchen ist nun noch den *PyCharm Debugger* so zu konfigurieren, dass wir unsere Anwendung auch direkt in *PyCharm* debuggen können. Hierzu müssen wir zuerst *Python Remote Debug* in *PyCharm* konfigurieren:
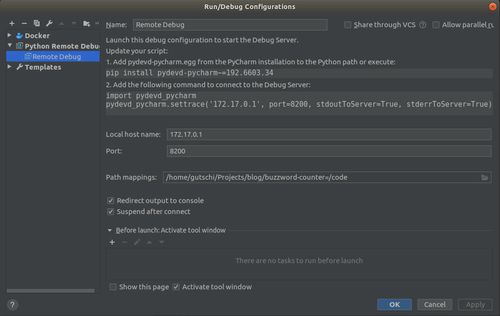
Zu beachten ist das Pfad-Mapping, denn hier muss unbedingt ein **absoluter Pfad** angegeben werden (der ~-Shortcut für das Home-Verzeichnis funktioniert nicht). Wie oben im Bild zu sehen ist, benötigt die Konfiguration außerdem eine spezifische Version des
Python-Packages
*pydevd-pycharm*.
Um zu verhindern, dass dieses Paket unnötig in unserem Production-Deployment ist, erzeugen wir ein zweites Dockerfile, das erweiterte *pip-Requirements* installiert. Weiterhin haben wir einen simplen View zu unserer Anwendung hinzugefügt (in *urls.py*), damit wir bequem per URL die Verbindung zwischen unserem Cluster und dem *PyCharm Debugger* herstellen können. Hier ist insbesondere darauf zu achten, dass die IP-Adresse und der Port mit der Konfiguration in *PyCharm* übereinstimmen.
```docker
docker build -f Dockerfile.dev -t buzzword-counter:debug .
telepresence --swap-deployment buzzword-counter-web --expose 8080 --docker-run --rm -it -v $(pwd):/code buzzword-counter:debug bash
```
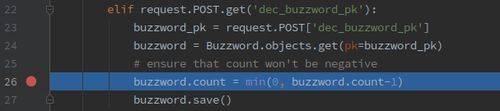
Daraufhin browsen wir die *Debug-URL* an. Auch hier müssen wir wieder daran denken, dass *DEBUG=True* gesetzt ist und wir den port-forward durchgeführt haben. Nun können wir auch schon einen **Breakpoint** in *PyCharm* setzen. Browsen wir den entsprechenden View an, wird die Ausführung durch den Debugger angehalten und wir können genauer untersuchen, warum ein Reduzieren des Counters diesen entweder auf 0 zurücksetzt oder sogar ein *IntegrityError* kommt:
**FAZIT**
Mittels der **Tools** *k3d/k3s, Helm, Telepresence und Python Remote Debug* haben wir also das Brett namens **“Cloud Native k8s Development”** komplett durchbohrt. Unsere Entwickler können nun alle munter in ihrem **eigenen lokalen Kubernetes-Cluster entwickeln.** Vor allem *Telepresence* in Kombination mit *Python Remote Debug* ist eine sehr praktische Lösung.
Dennoch muss man festhalten, dass die **Handhabung der Tools** nicht ganz simpel ist bzw. eine **gewisse Einarbeitungszeit** benötigt. Vor allem im Vergleich zu *docker-compose* ist die Hürde wesentlich höher. Hier fehlt noch etwas, das die genannten Tools kombiniert und sich dennoch **ohne große Einstiegshürde** bedienen lässt. Bleibt gespannt, wir bei Blueshoe haben in letzter Zeit an einer **Lösung** gebastelt, die sich intern bereits bewährt hat. Demnächst werdet ihr auch in unserem Blog mehr davon lesen!
Abschließend natürlich noch der **Buzzword-Counter**: Ich bin insgesamt auf **23 unique Buzzwords** gekommen. Hast du mitgezählt und bist auf einen anderen Wert gekommen? Dann lass es uns doch einfach in einem Kommentar wissen.
## Sitemap
See the full [sitemap](/sitemap.md) for all pages.